Keurig vs. Nespresso
Cafeteras48 escenarios
Panel, mismo peso
- Claude Haiku 5.5anthropic/claude-haiku-5.5
- DeepSeek V4.1 Flashdeepseek/deepseek-v4.1-flash
- Gemini 3.8 Flashgoogle/gemini-3.8-flash
- GLM-5.3 Flashz-ai/glm-5.3-flash
- GPT-6 Lunaopenai/gpt-6-luna
- Grok 4.7x-ai/grok-4.7
- Kimi K3.1 Promoonshotai/kimi-k3.1-pro
- Llama 4 Maverickmeta-llama/llama-4-maverick-17b-128e-instruct
- Mistral Small 2603mistralai/mistral-small-2603
- Qwen3.8 Flashqwen/qwen3.8-flash
La respuesta
Demasiado reñidoPanel rápido
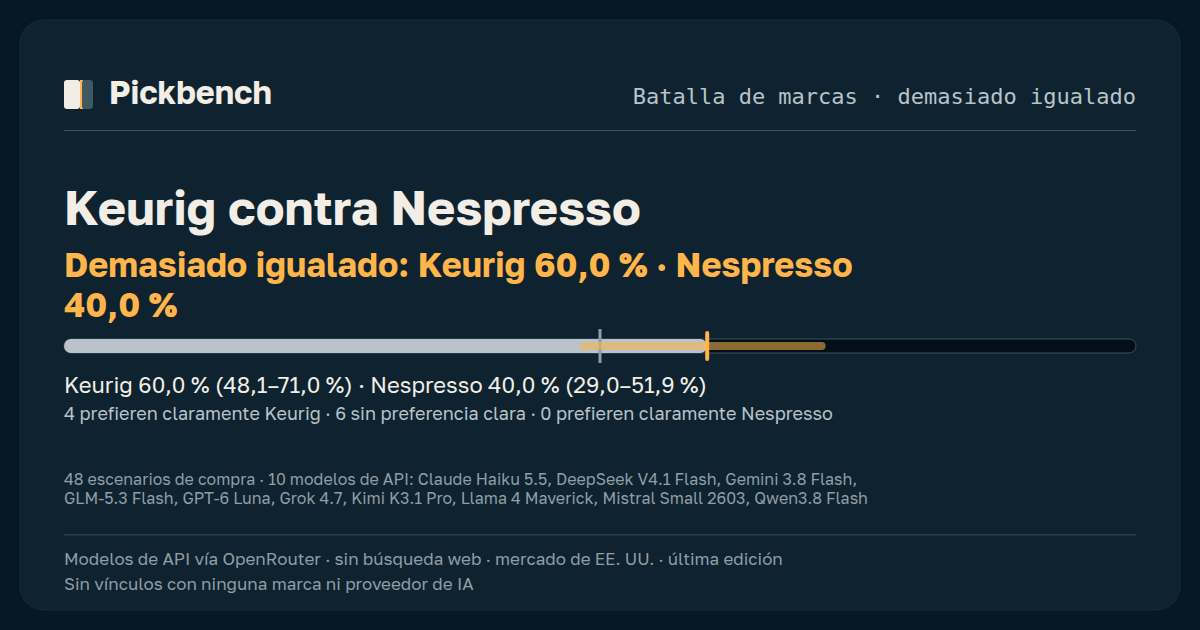
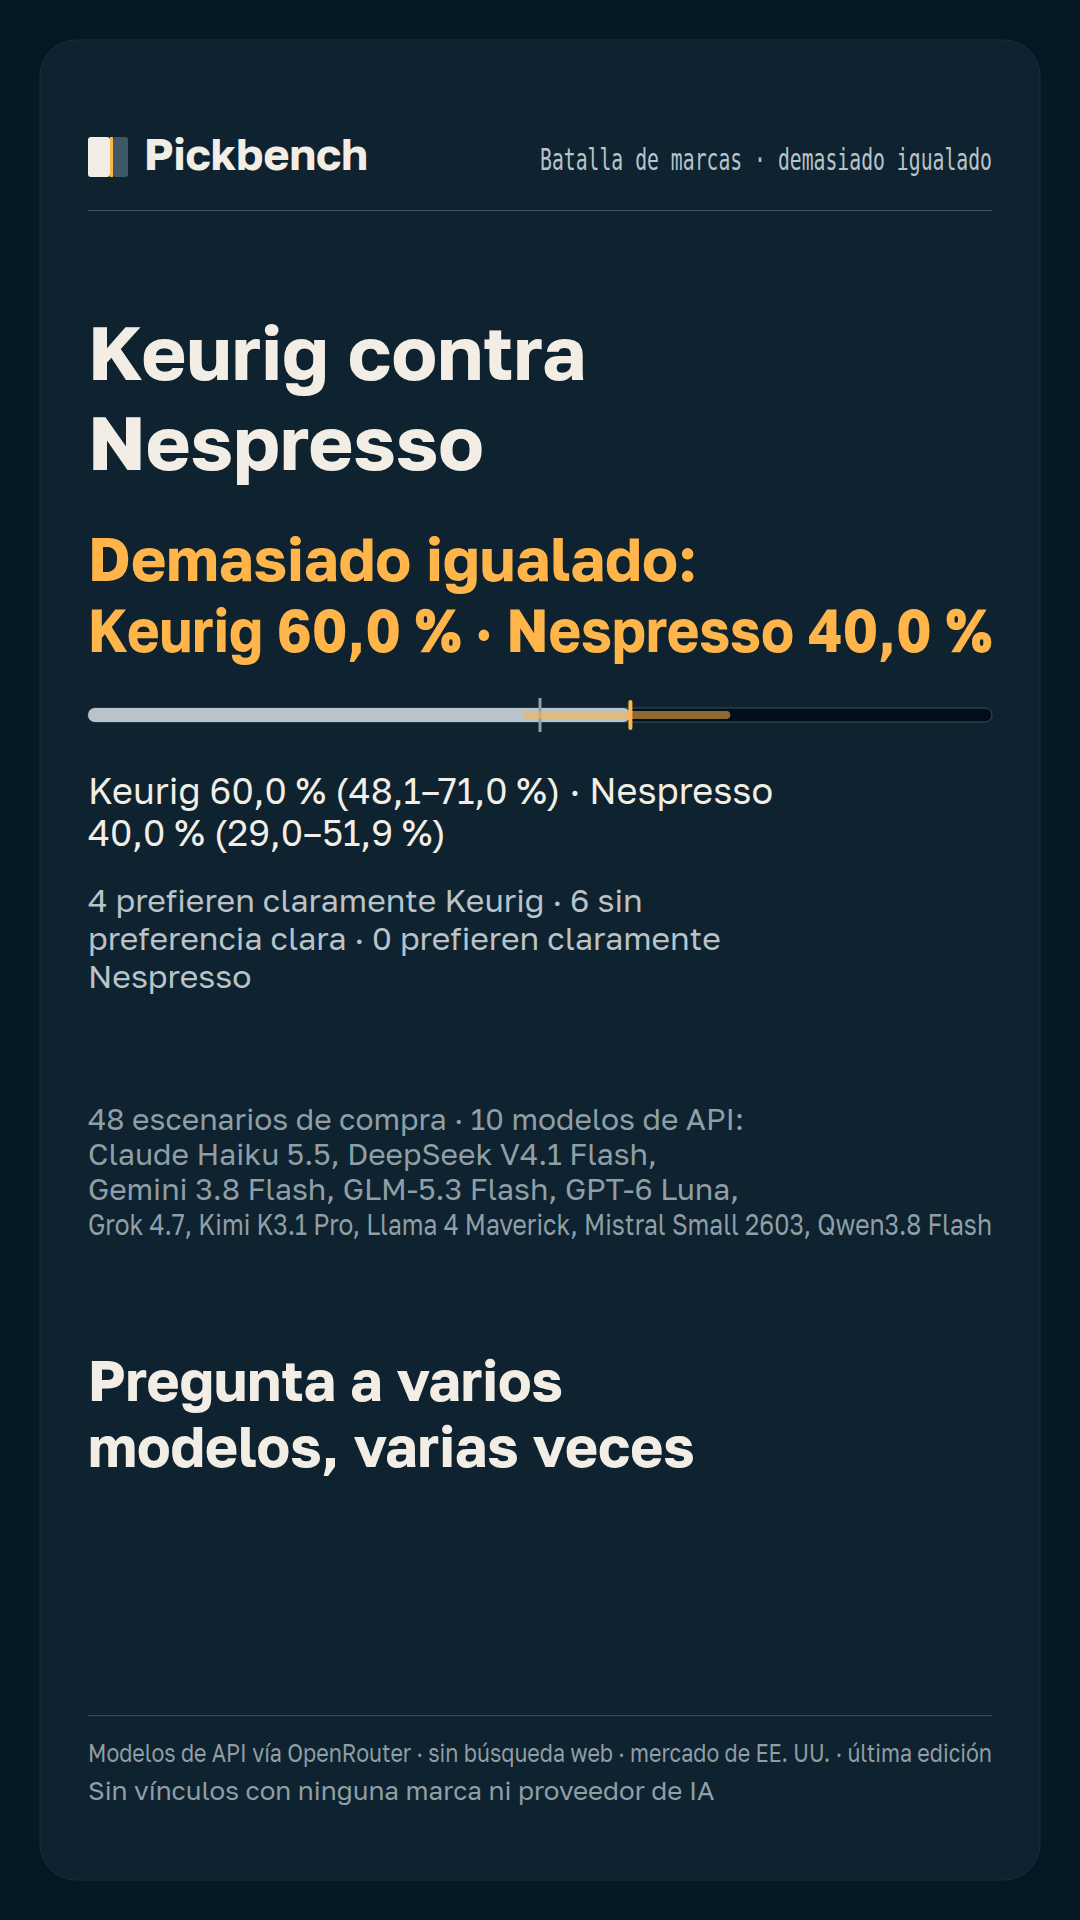
Demasiado igualado: Keurig 60 % · Nespresso 40 %
Dentro del margen de error — los 10 modelos en conjunto
4 prefieren claramente Keurig · 6 sin preferencia clara · 0 prefieren claramente Nespresso · los 10 modelos cuentan en el resultado general
Intervalo del 95 % para Keurig: 48–72 %
Detallescada modelo, intervalos, condiciones
Todos los modelos en conjunto
Panel rápidoDemasiado reñidoEl intervalo del panel incluye el 50 %: en conjunto, estos 10 modelos de API no eligen entre Keurig y Nespresso.
Keurig60 %

Nespresso40 %

- Intervalo de confianza para Keurig: 48–72 %
Consensointervalo del 95 % 48–72 %
Cada modelo
Cuota de la marca indicada en cada fila, con su intervalo
Barra: Keurig desde la izquierda, Nespresso desde la derecha; la línea discontinua es el 50 %.
| Juez (modelo de API) | Marca y cuota | Intervalo de confianza | Inclinación | Gráfico del intervalo |
|---|---|---|---|---|
| Claude Haiku 5.5 | Keurig: 66 % | 53–79 % | Preferencia clara | |
| DeepSeek V4.1 Flash | Keurig: 59 % | 44–73 % | Sin preferencia clara | |
| Gemini 3.8 Flash | Keurig: 53 % | 39–67 % | Sin preferencia clara | |
| GLM-5.3 Flash | Keurig: 65 % | 51–78 % | Preferencia clara | |
| GPT-6 Luna | Keurig: 67 % | 55–78 % | Preferencia clara | |
| Grok 4.7 | Keurig: 52 % | 39–66 % | Sin preferencia clara | |
| Kimi K3.1 Pro | Keurig: 65 % | 51–78 % | Preferencia clara | |
| Llama 4 Maverick | Keurig: 53 % | 40–66 % | Sin preferencia clara | |
| Mistral Small 2603 | Keurig: 61 % | 47–74 % | Sin preferencia clara | |
| Qwen3.8 Flash | Keurig: 59 % | 46–73 % | Sin preferencia clara |
Repetir como caída de bolasSimulación
Simulación: recorridos de escenarios inventados para reproducir las cuotas publicadas por juez, no filas medidas.
Demasiado reñido para decidir: el intervalo de confianza incluye el 50 %
Intervalo de confianza del 95 % publicado para Keurig: 48–72 %. Pulse Soltar para ver dónde caen los escenarios simulados.
Cómo leerlo
Cada bola es un escenario de compra simulado. Cada fila de clavos es un modelo de IA que empuja la bola hacia la marca que eligió.
Una tirada es una muestra. Suelte otra vez y el montón se mueve; la banda naranja muestra dónde cae el equilibrio en el 95 % de las tiradas.
Solo se nombra una marca líder cuando la banda no toca el centro. Los recorridos se simulan a partir de las cuotas publicadas por juez: ningún modelo vio estos escenarios.
- Otras necesidades
Toque para soltar. Mantenga pulsado para seguir soltando.
Las cifras detrás de la máquina
008245a517e3JSONCompartir
Compartir este resultado
Publicar
- X (se abre en una pestaña nueva)
- Threads (se abre en una pestaña nueva)
- Bluesky (se abre en una pestaña nueva)
- Reddit (se abre en una pestaña nueva)
- LinkedIn (se abre en una pestaña nueva)
- Facebook (se abre en una pestaña nueva)
- WhatsApp (se abre en una pestaña nueva)
- Telegram (se abre en una pestaña nueva)
- Correo
Descargar imagen
Insertar
Insertarlo es gratis. Muestra la última edición; conserva la línea de fuente y el enlace.

Cómo se midió · verificar
Cómo leer
La cuota es la frecuencia con que los modelos eligieron cada marca, con su intervalo del 95 %. Una marca va por delante solo si todo su intervalo está por encima del 50 %, para todos los modelos en conjunto y para cada modelo por separado; si no, está demasiado igualado.
Cada página muestra la última edición. Las fechas están en el JSON descargable.
Quién se tuvo en cuenta
- Según la regla de inclusión prerregistrada, se contaron los resultados de 10 de los 10 jueces del panel.
- Los resultados usan 48 de los 48 escenarios planificados.
- Todos los jueces del panel cumplen la regla.
Pesos en el consenso de 10 jueces contados
| Juez (modelo de API) | Familia de modelos | Peso en el consenso |
|---|---|---|
| Claude Haiku 5.5 | Anthropic | 10,0 % |
| DeepSeek V4.1 Flash | DeepSeek | 10,0 % |
| Gemini 3.8 Flash | 10,0 % | |
| GLM-5.3 Flash | Z.ai | 10,0 % |
| GPT-6 Luna | OpenAI | 10,0 % |
| Grok 4.7 | xAI | 10,0 % |
| Kimi K3.1 Pro | Moonshot AI | 10,0 % |
| Llama 4 Maverick | Meta | 10,0 % |
| Mistral Small 2603 | Mistral AI | 10,0 % |
| Qwen3.8 Flash | Qwen | 10,0 % |
Resultados por necesidad
Los resultados por necesidad no se publican: 6 escenarios por necesidad, por debajo del mínimo prerregistrado de 30.
8 necesidades del comprador
- Fiabilidad diaria económica
- Encimera de cocina pequeña
- Diseño y calidad de construcción
- Limpieza fácil y poco mantenimiento
- Mañanas rápidas entre semana
- Sabor y temperatura de preparación
- Bebidas especiales y con hielo
- Invitados y raciones familiares
Metodología
Cada juez es un modelo de IA consultado mediante una API; «Sobre este resultado» indica cada modelo y cómo se consultó. En cada escenario de compra, el juez elige entre las dos marcas. El escenario es la unidad de análisis.
- Versión
ACM-1.0- Precisión
- Medida
- Consenso, necesidades e idiomas
- Intervalos de confianza del 95 % (combinación MOVER de los intervalos de cada juez, ampliada para muestras pequeñas en batallas y tableros nuevos). El consenso da el mismo peso a cada familia de modelos. Los resultados por juez, en «Cada modelo», son la medida principal.
- Por juez
- Intervalos de confianza del 95 % (envolvente de los intervalos bootstrap por conglomerados de escenarios y de Wilson, ampliada para muestras pequeñas en batallas y tableros nuevos). La opinión de un solo modelo es un juez, no el consenso.
- Panel
- Panel rápido: los modelos actuales rápidos o pequeños de cada proveedor, no el panel completo de modelos insignia.
Avisos sobre los datos
- Solo nombres de marca: los modelos vieron cada opción como un nombre de marca, sin datos de producto, y respondieron con su propio conocimiento.
Sobre este resultado
- Modelos de IA (API)
- Claude Haiku 5.5
- DeepSeek V4.1 Flash
- Gemini 3.8 Flash
- GLM-5.3 Flash
- GPT-6 Luna
- Grok 4.7
- Kimi K3.1 Pro
- Llama 4 Maverick
- Mistral Small 2603
- Qwen3.8 Flash
Cada modelo se llamó vía OpenRouter (proveedores fijados).
- Condiciones
- Cada modelo eligió entre las dos marcas en 48 escenarios de compra. Idiomas de los escenarios: inglés.
- Prerregistro (SHA-256)
bb7b2a10ae62…Qué fija el prerregistro- Instantánea firmada
Verificar este resultado: descargar la instantánea firmada (JSON)
- Clave de firma (kid)
FnG9tqyrr6Y0…· Clave de producción- SHA-256 del contenido (payload)
008245a517e3…
Las posiciones, la inclusión y la influencia en los resultados nunca se venden.