Pick Drift
Una pregunta, tres intentos: ¿cambia su elección el modelo de IA?
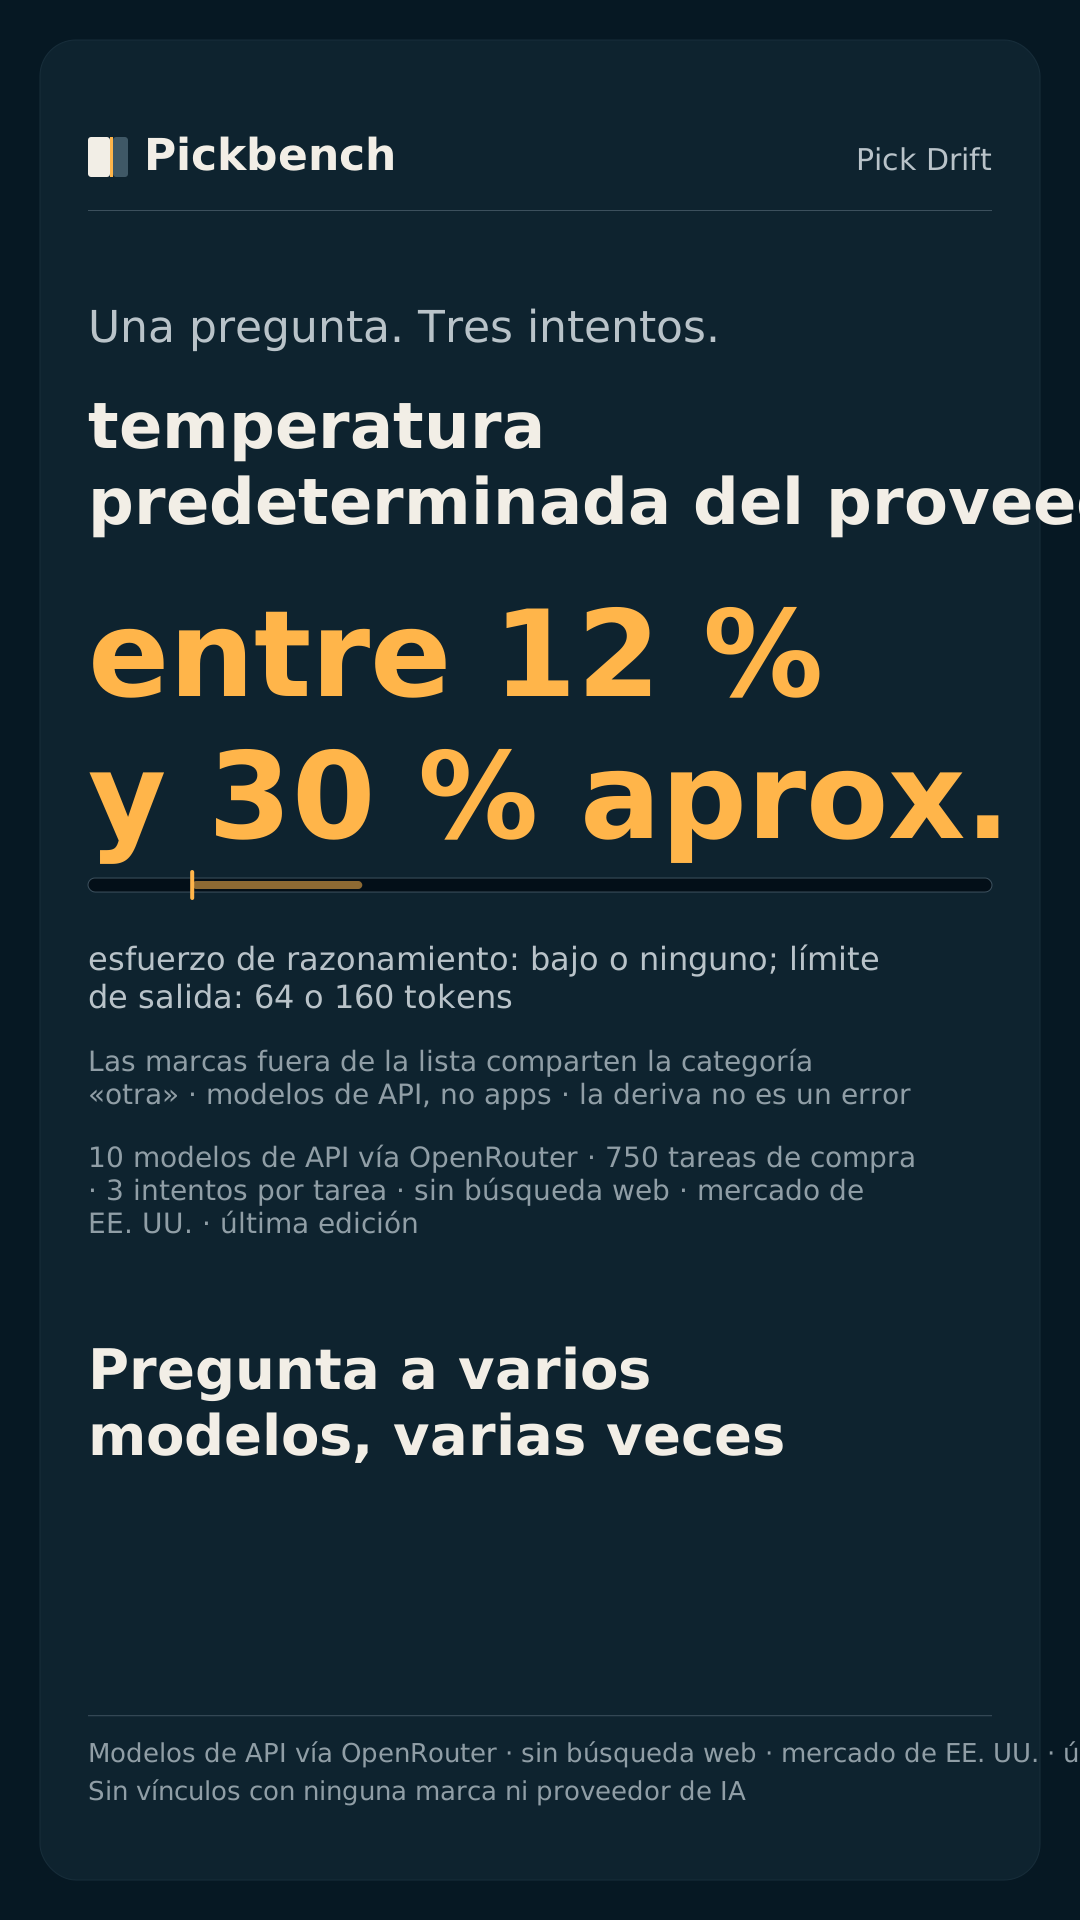
Temperatura predeterminada del proveedor
aprox. 12–30 %
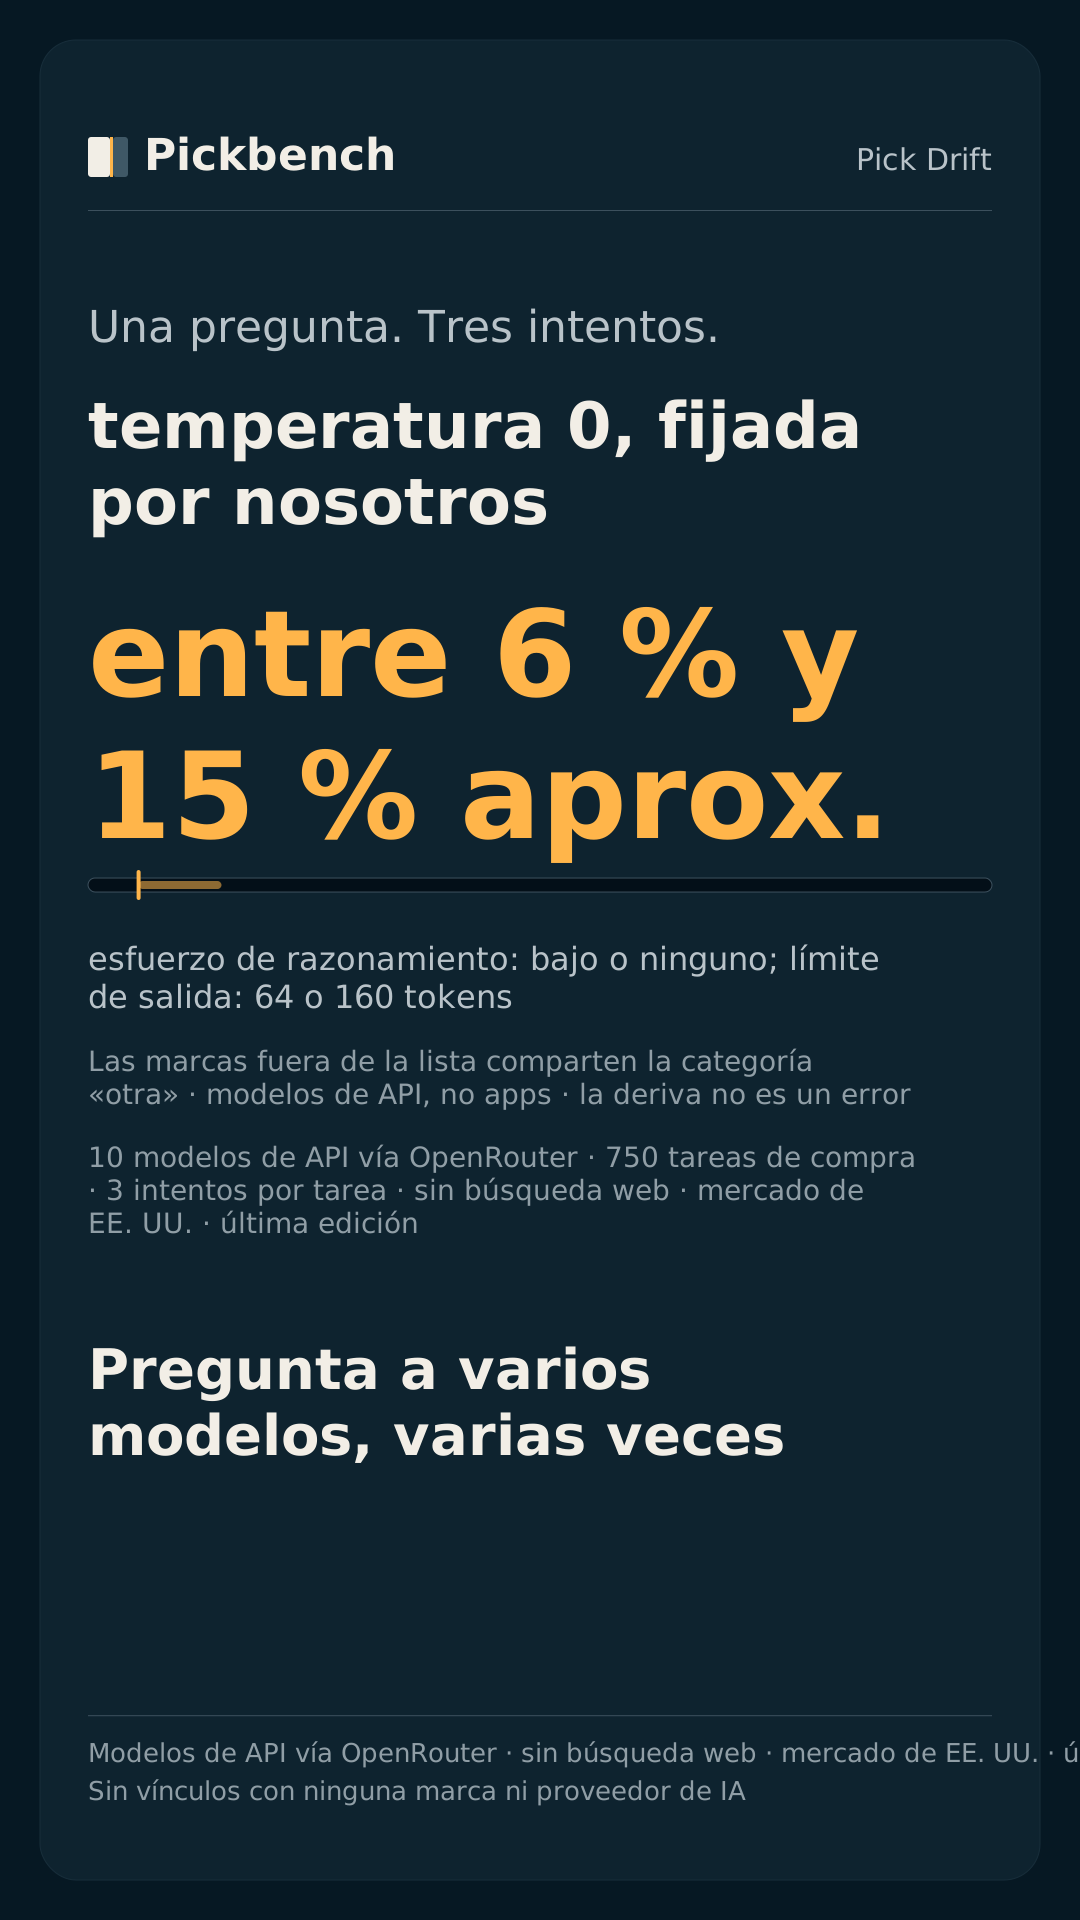
Temperatura 0, fijada por nosotros
aprox. 6–15 %
Todos los modelos, por ajuste
Temperatura predeterminada del proveedor
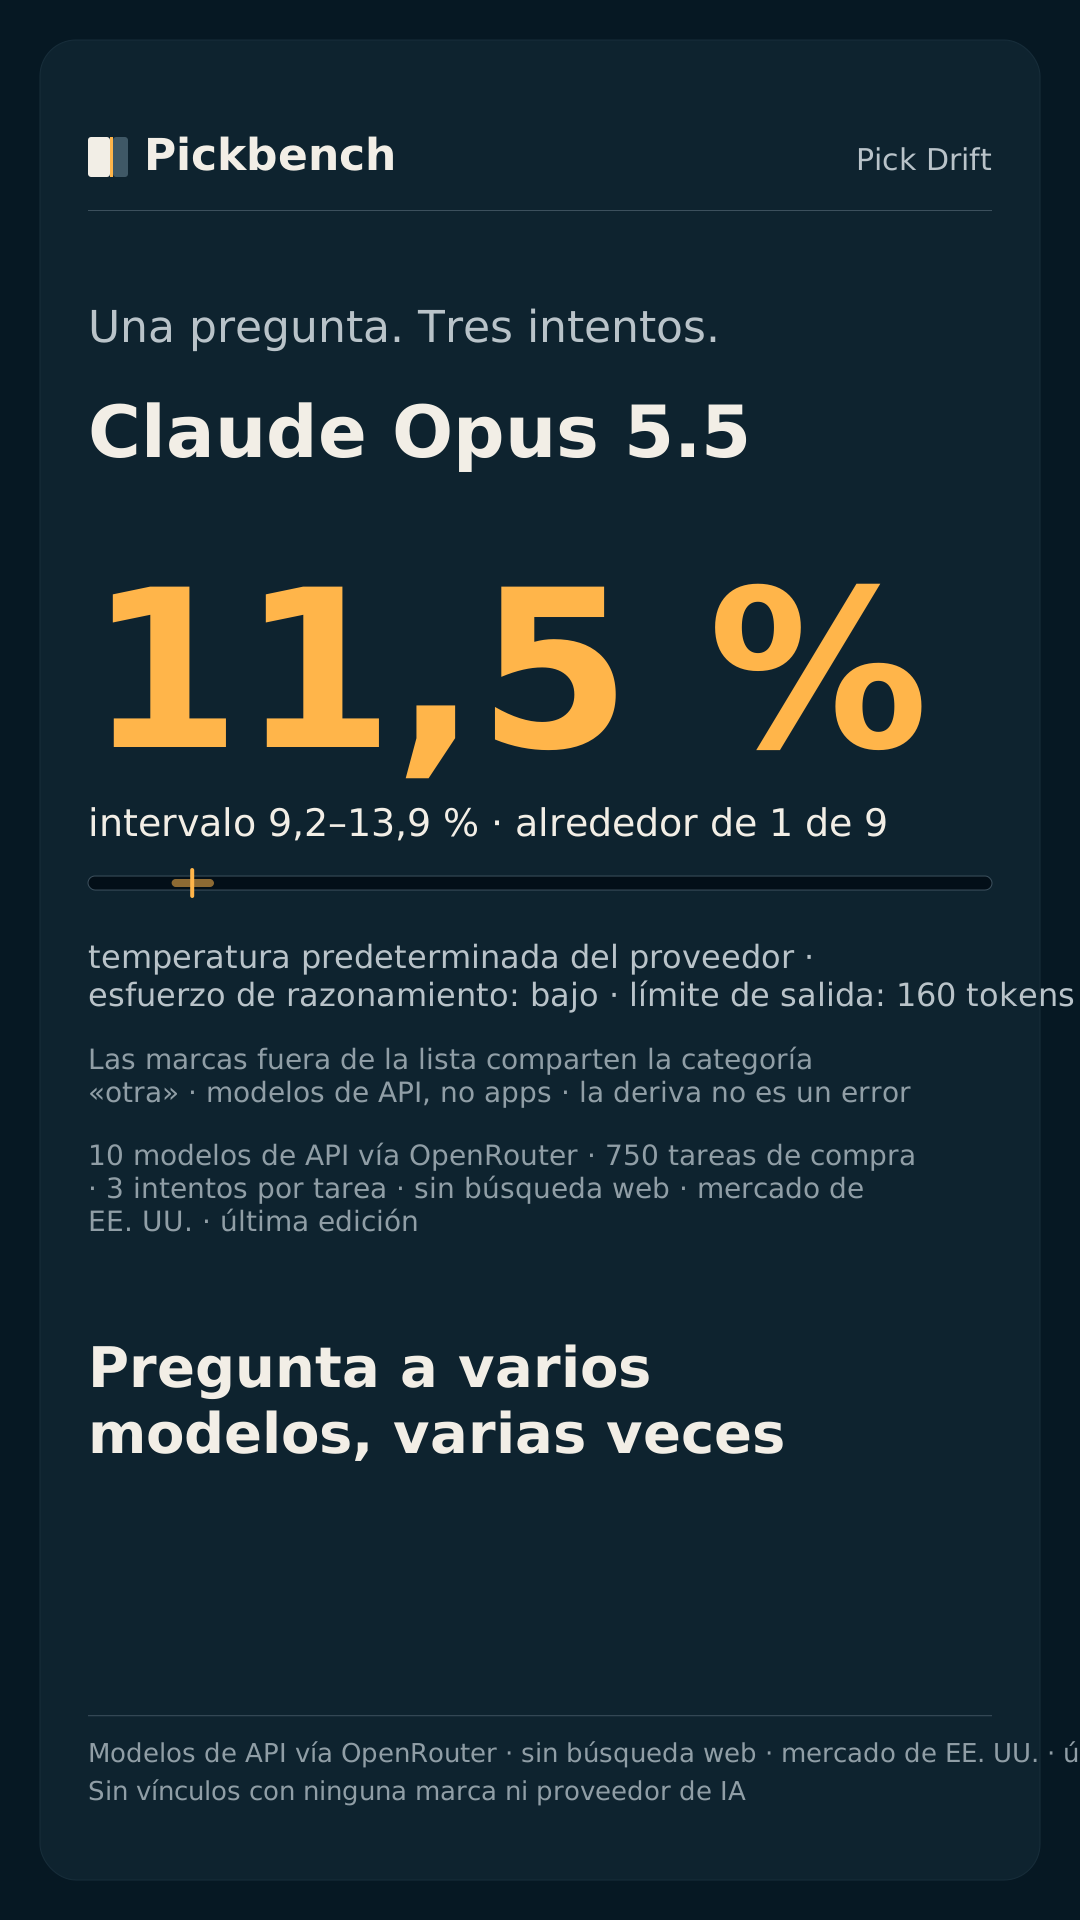
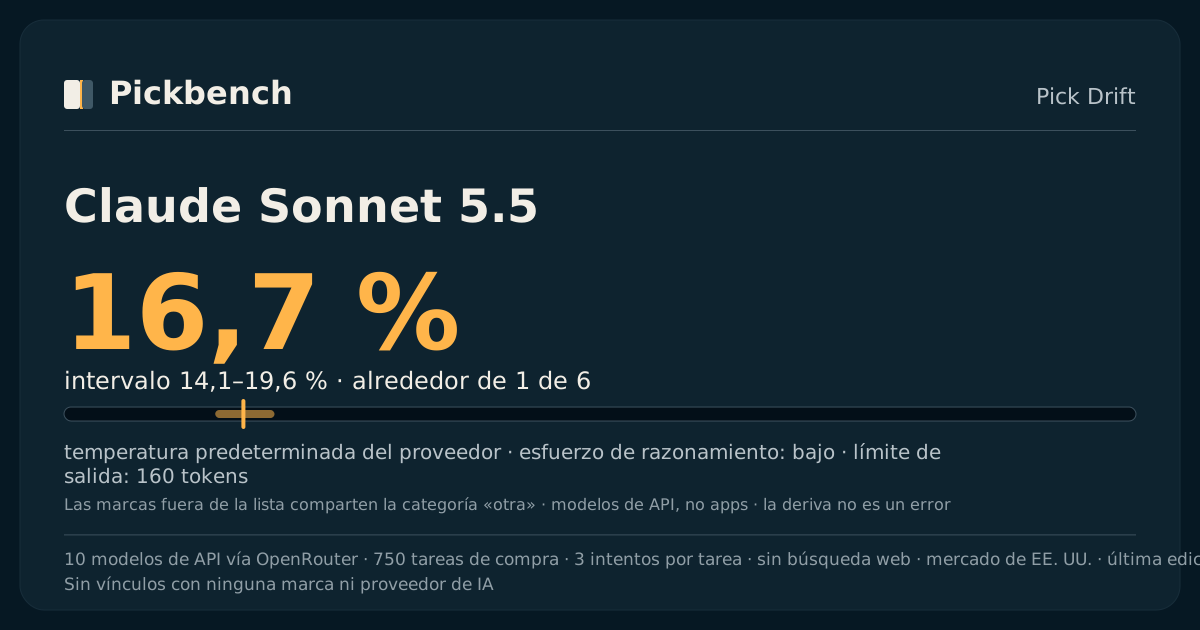
Esfuerzo de razonamiento: bajo · límite de salida: 160 tokens
- Claude Opus 5.511,5 %9,2–13,9 %
Detalles
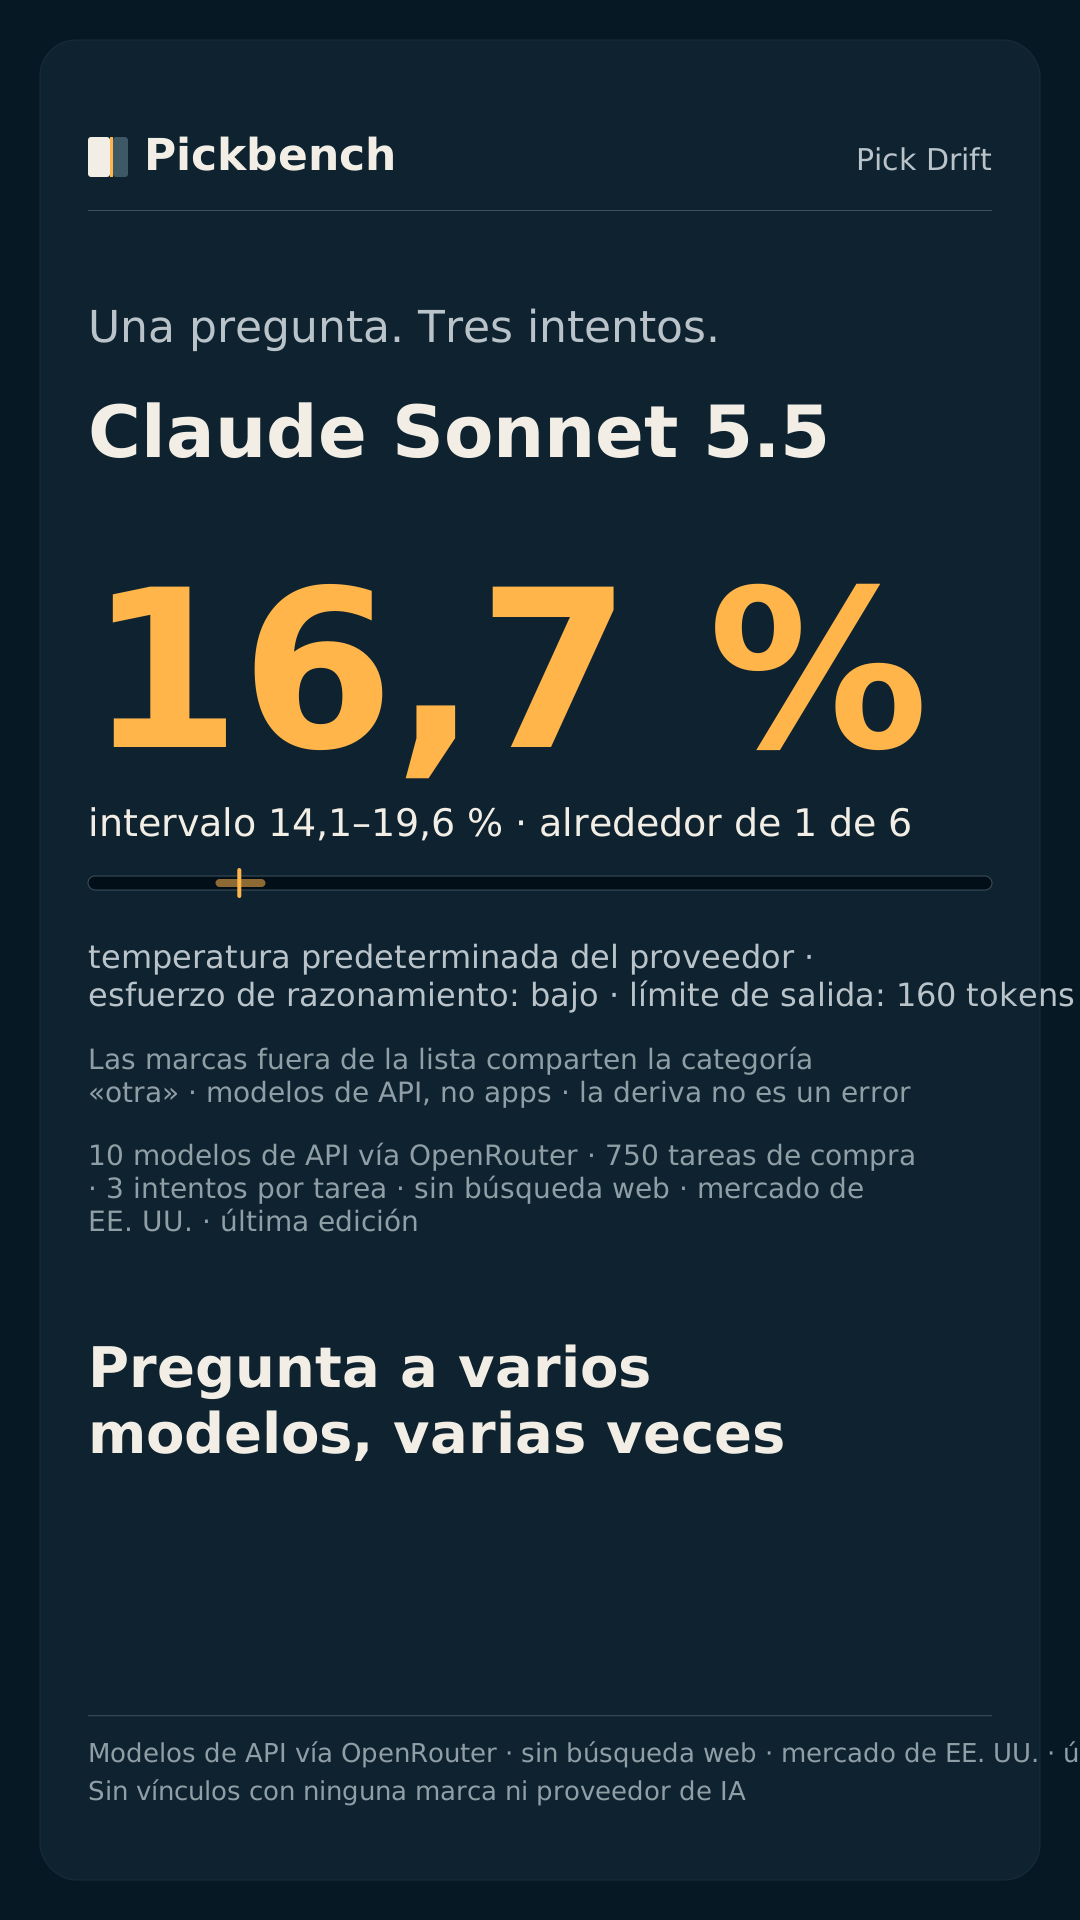
alrededor de 1 de 9 · Dos intentos difieren 7,9 % (6,4–9,5 %) - Claude Sonnet 5.516,7 %14,1–19,6 %
Detalles
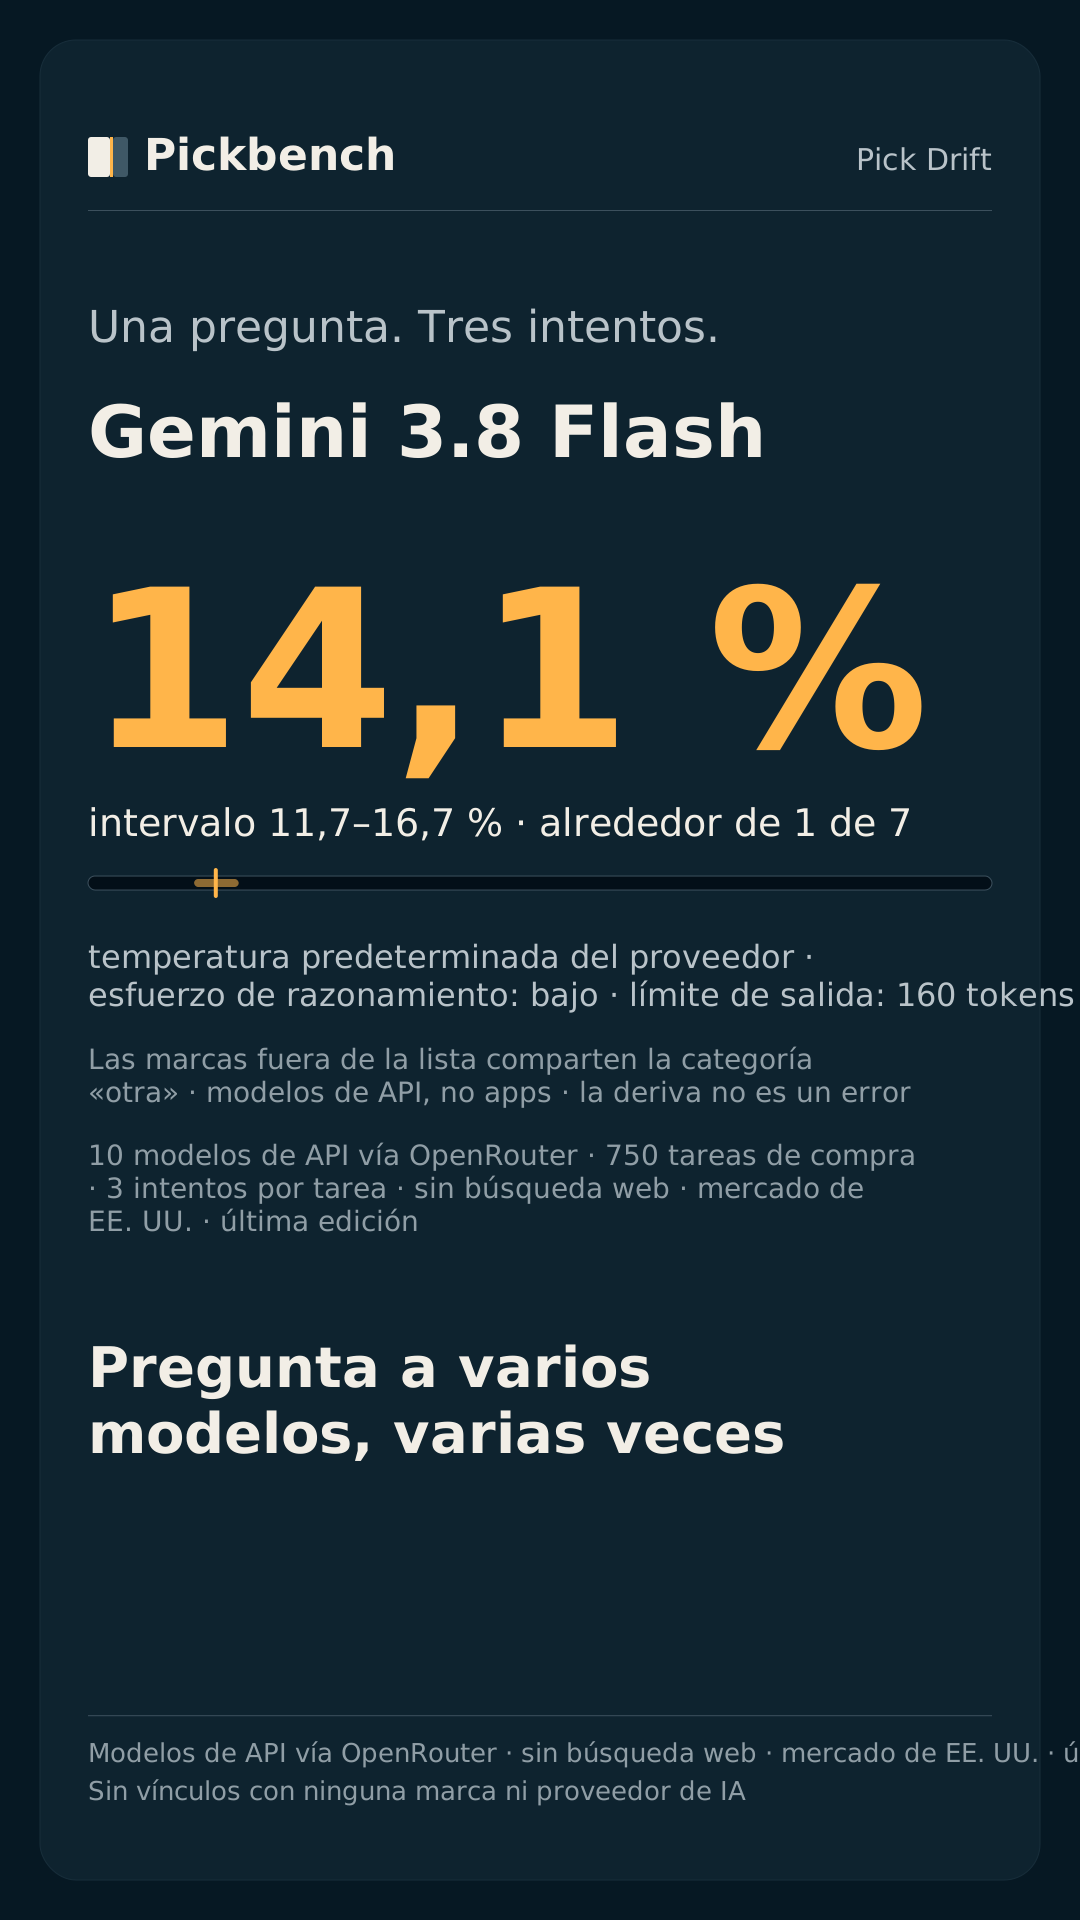
alrededor de 1 de 6 · Dos intentos difieren 11,2 % (9,5–13,1 %) - Gemini 3.8 Flash14,1 %11,7–16,7 %
Detalles
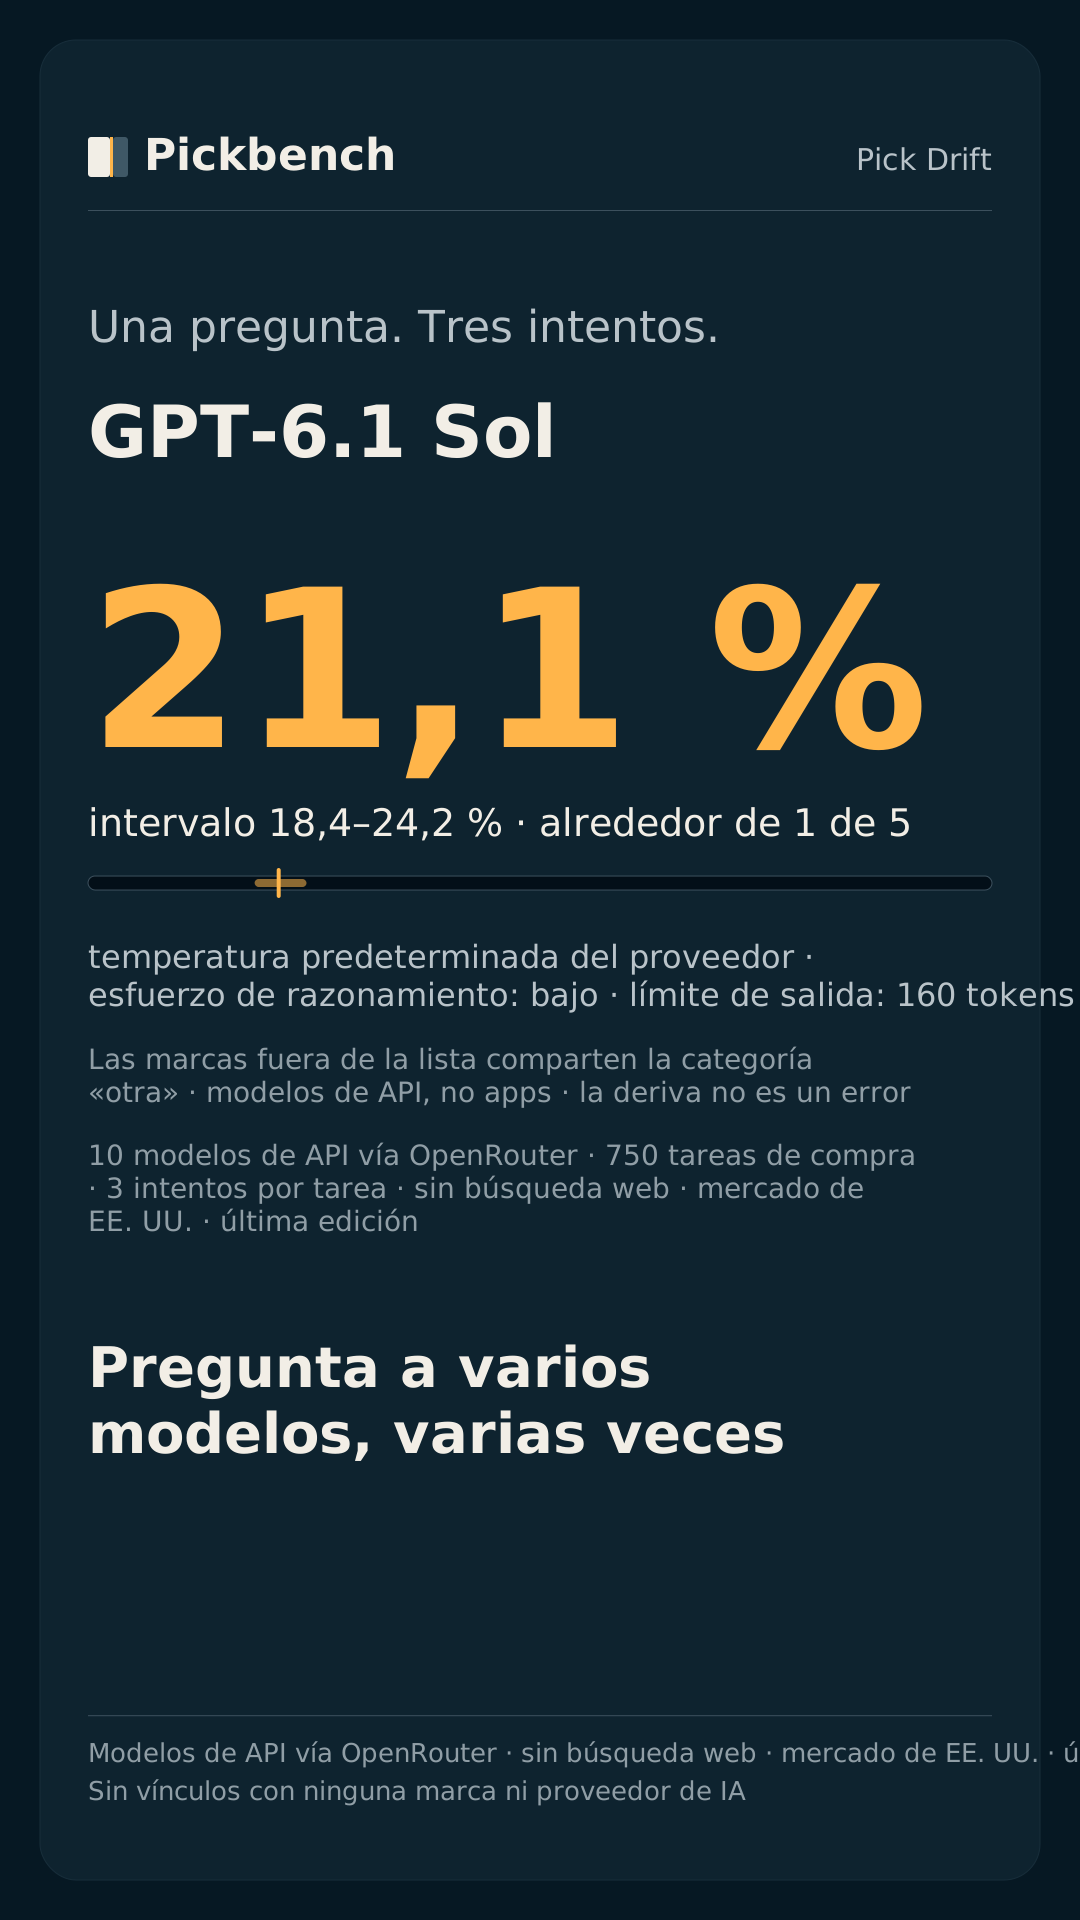
alrededor de 1 de 7 · Dos intentos difieren 9,6 % (8,0–11,3 %) - GPT-6.1 Sol21,1 %18,4–24,2 %
Detalles
alrededor de 1 de 5 · Dos intentos difieren 14,5 % (12,6–16,6 %)
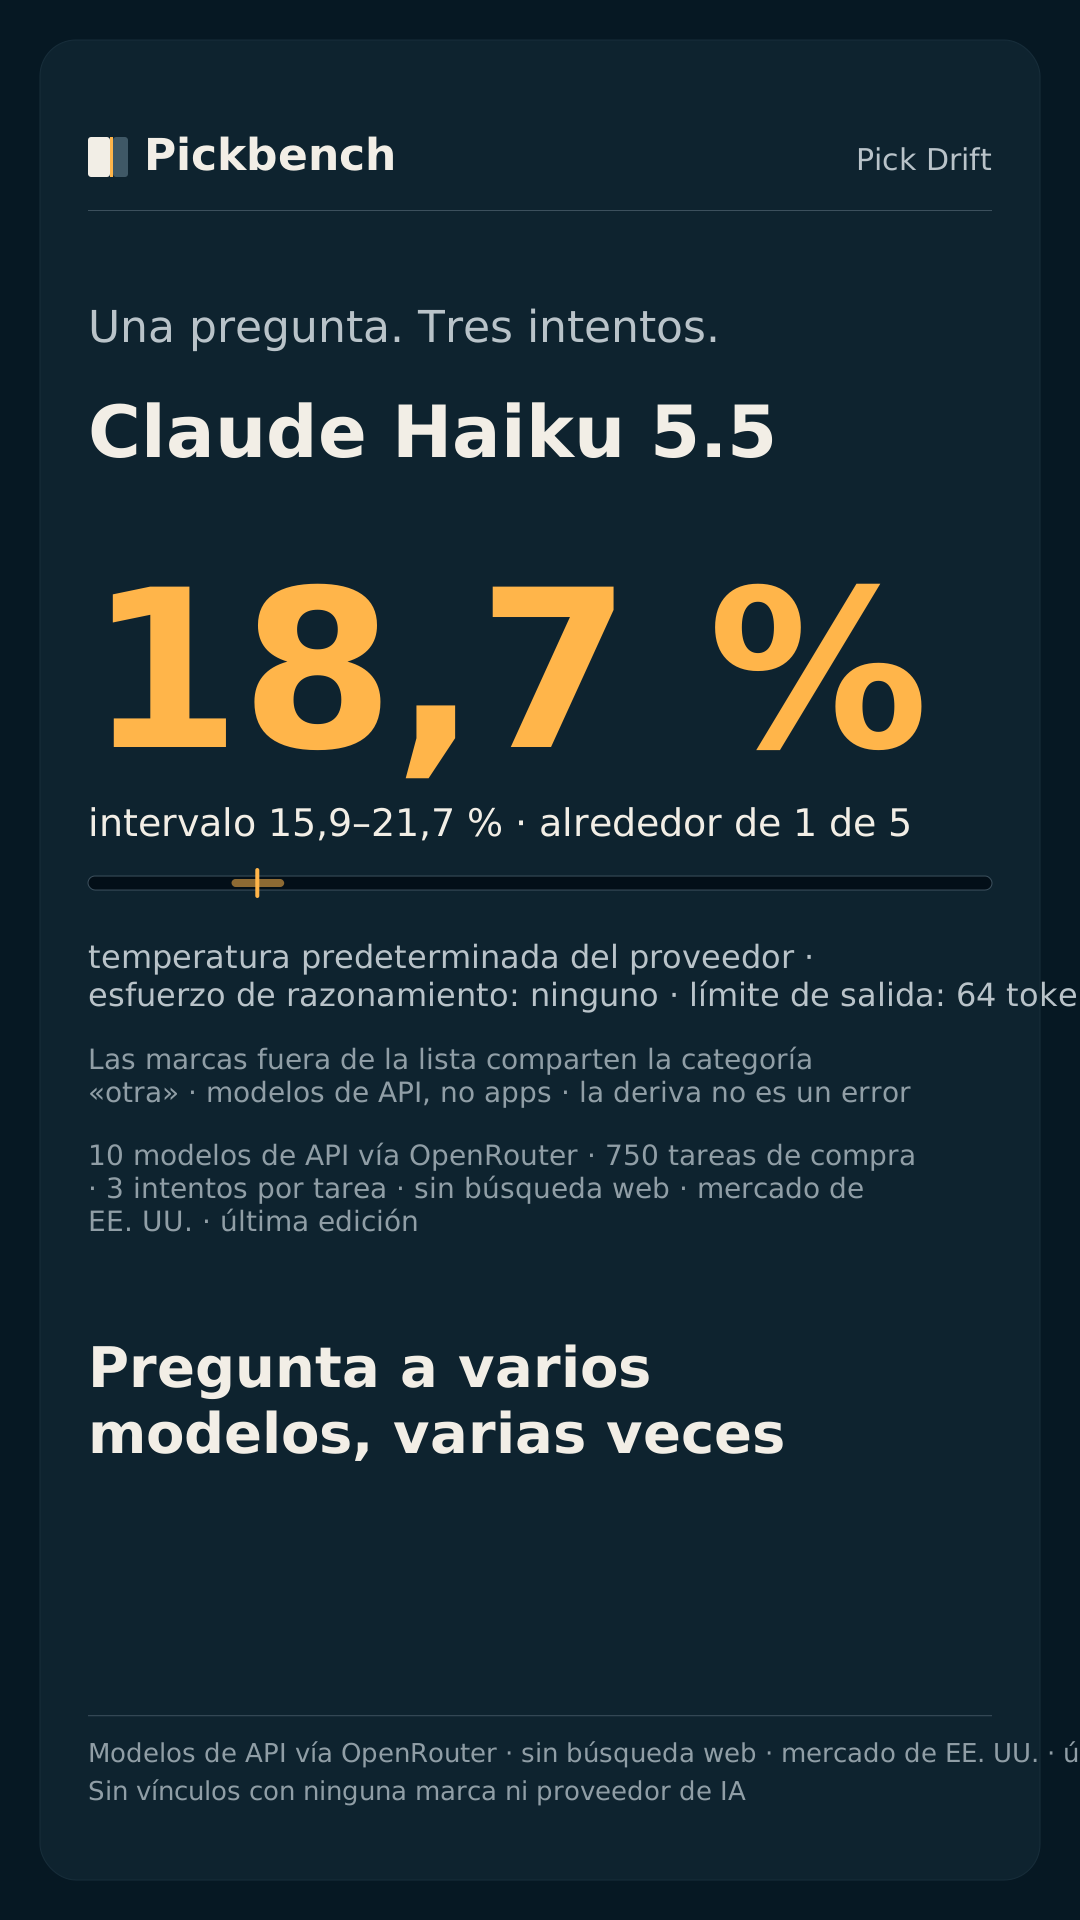
Esfuerzo de razonamiento: ninguno · límite de salida: 64 tokens
- Claude Haiku 5.518,7 %15,9–21,7 %
Detalles
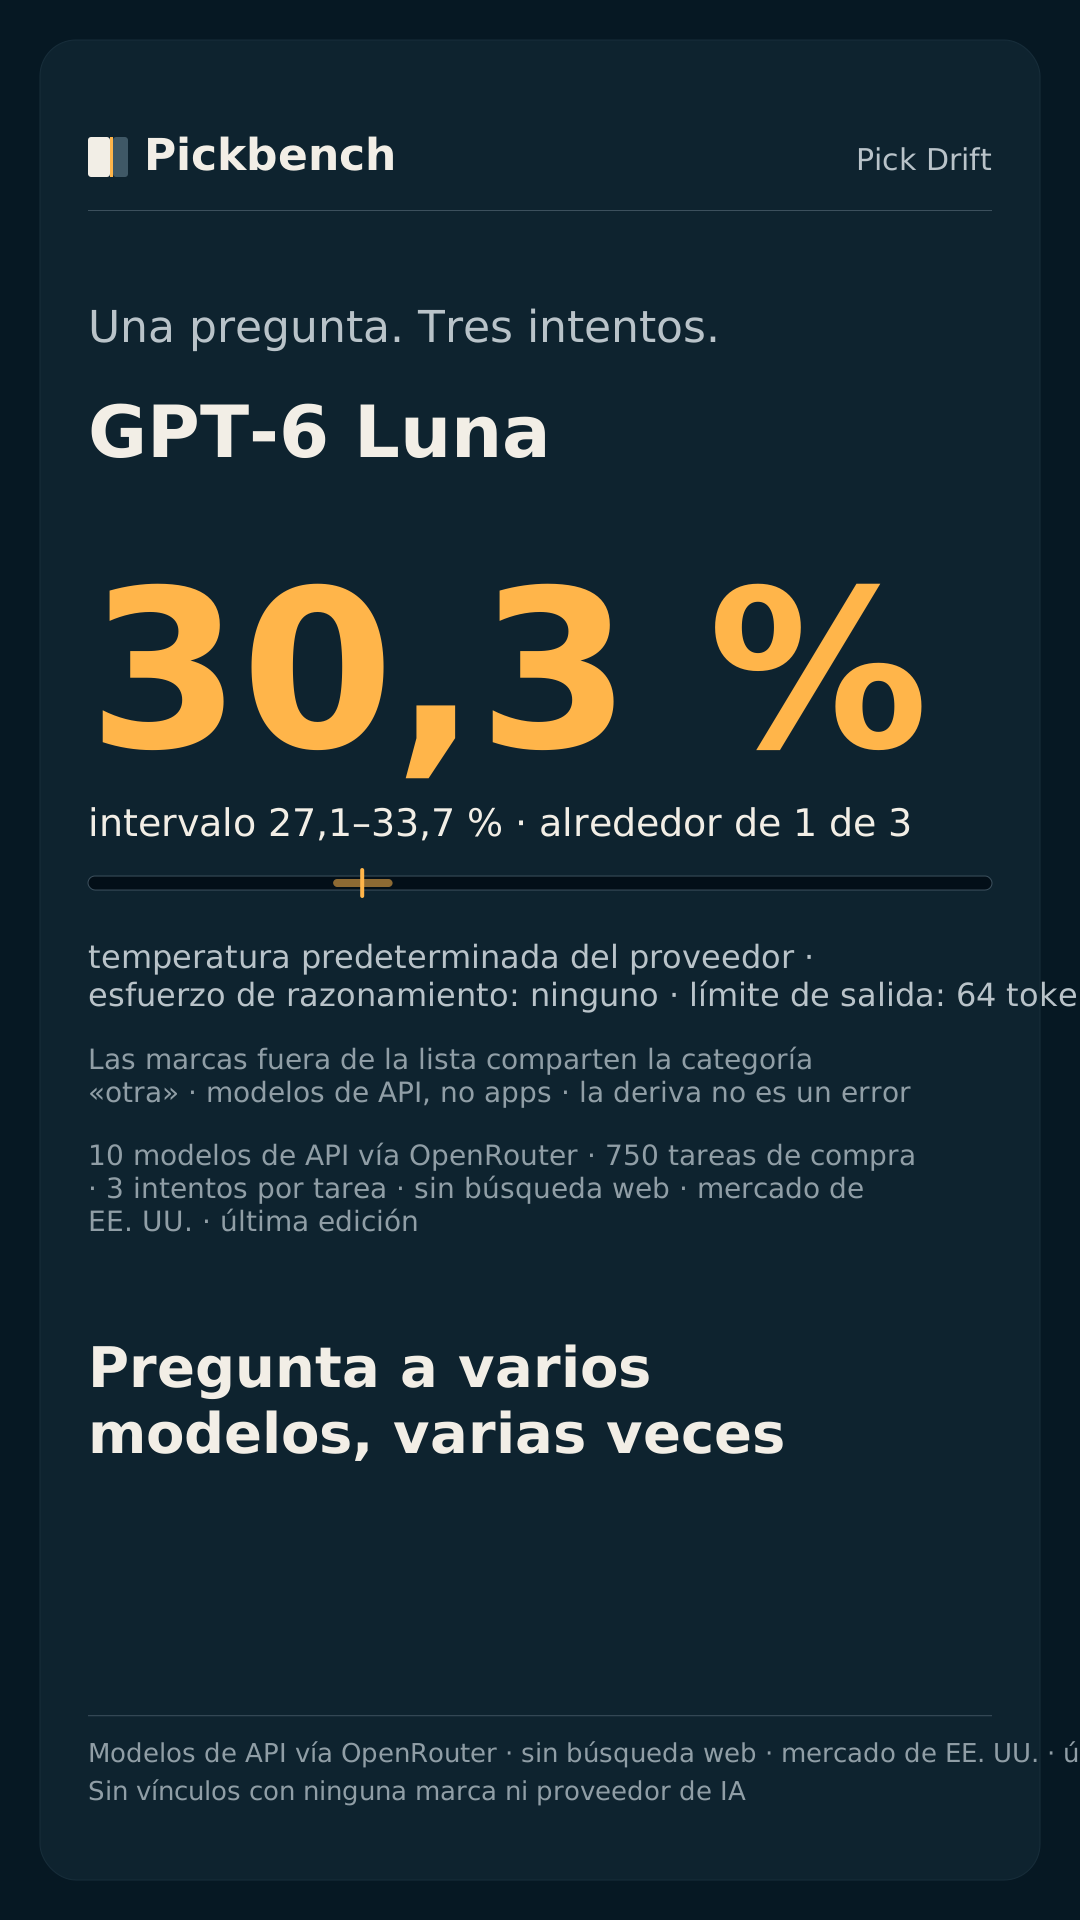
alrededor de 1 de 5 · Dos intentos difieren 13,1 % (11,1–15,2 %) - GPT-6 Luna30,3 %27,1–33,7 %
Detalles
alrededor de 1 de 3 · Dos intentos difieren 21,2 % (18,9–23,5 %)
Temperatura 0, fijada por nosotros
Esfuerzo de razonamiento: bajo · límite de salida: 160 tokens
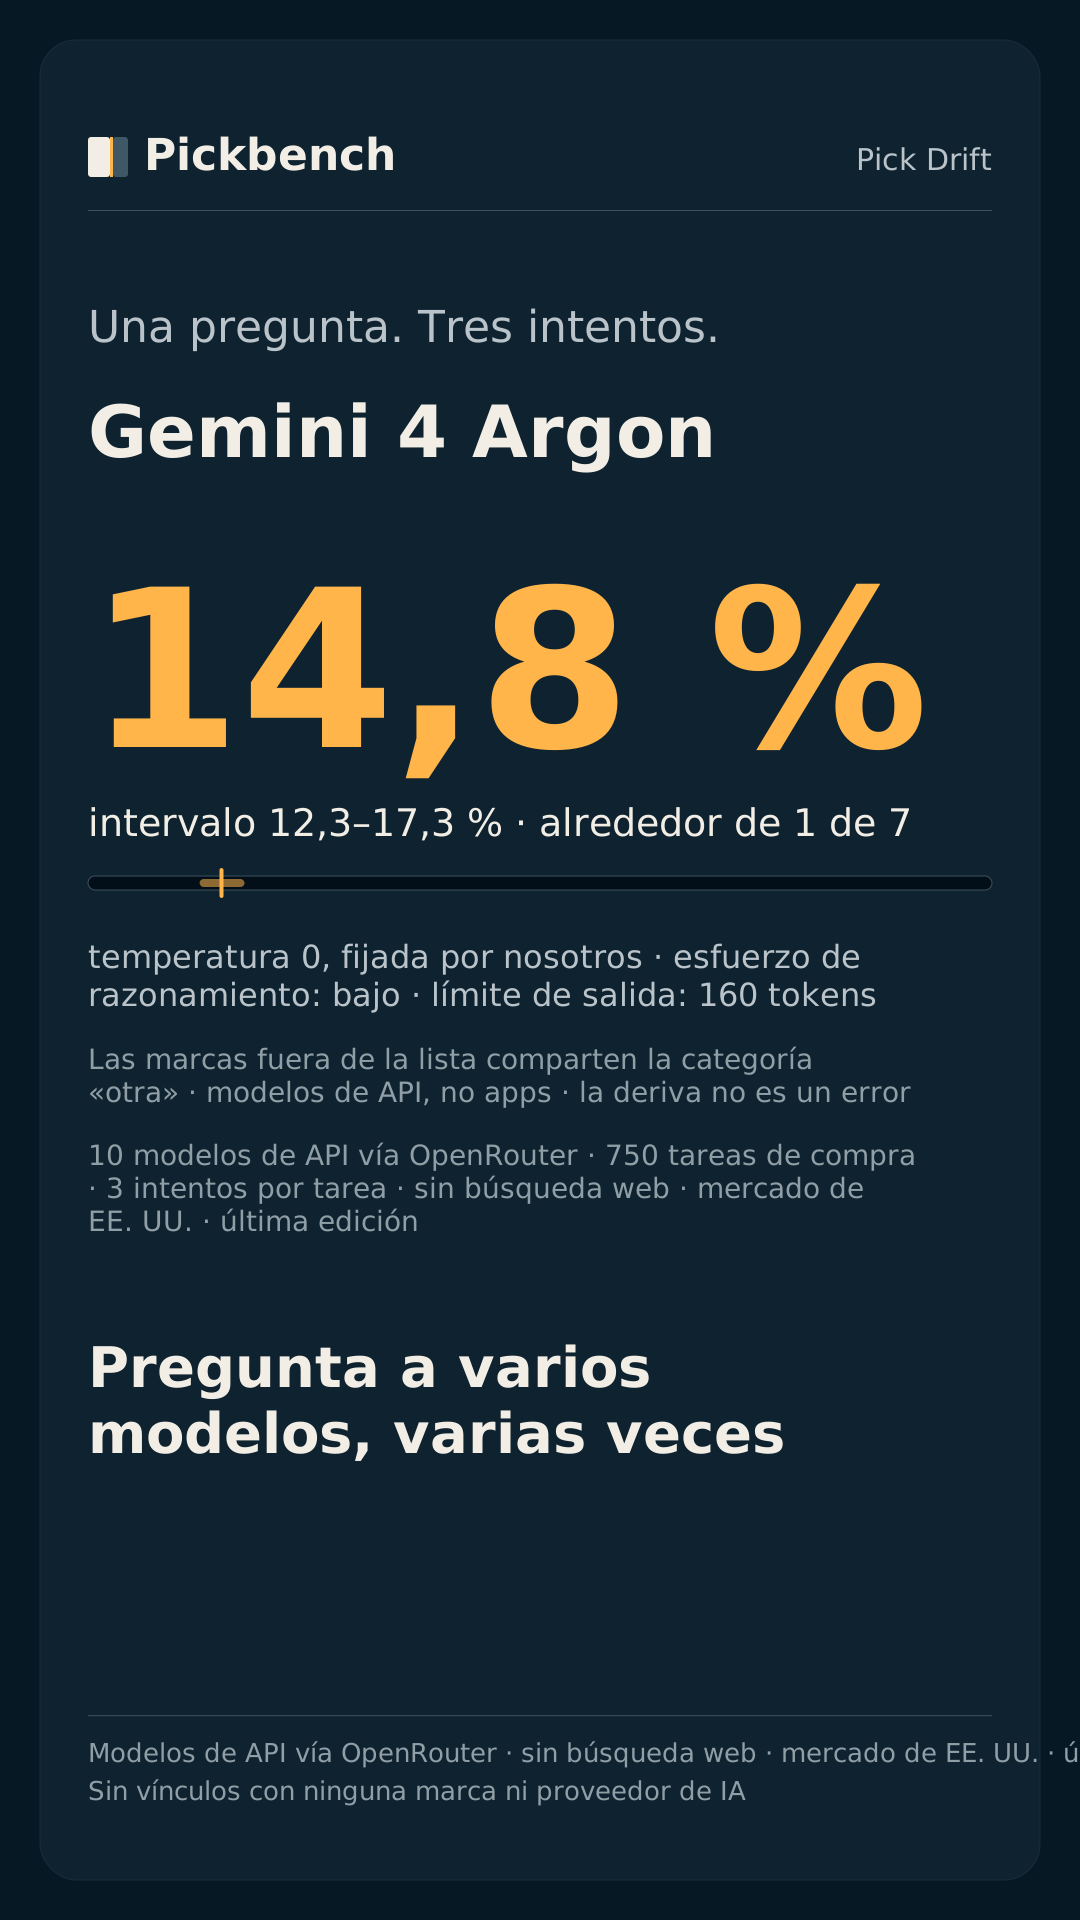
- Gemini 4 Argon14,8 %12,3–17,3 %
Detalles
alrededor de 1 de 7 · Dos intentos difieren 10,1 % (8,4–11,8 %)
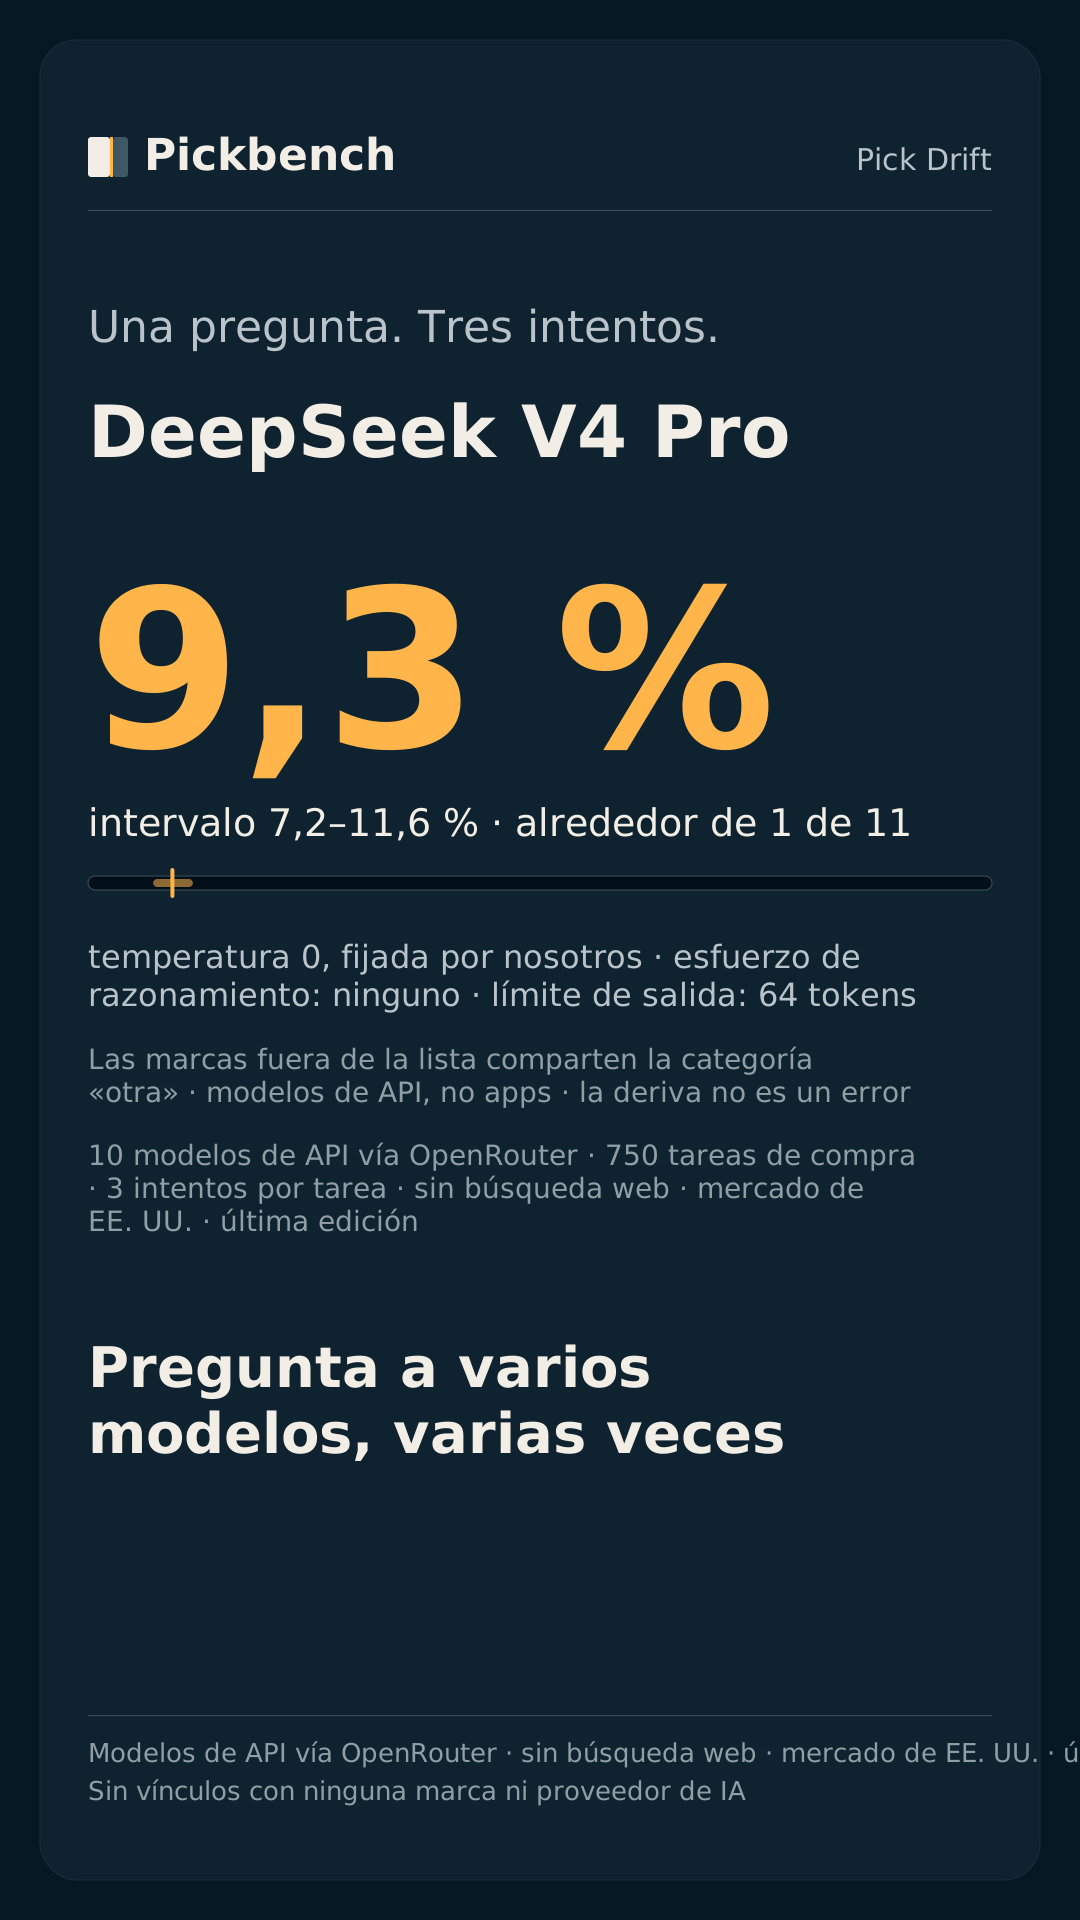
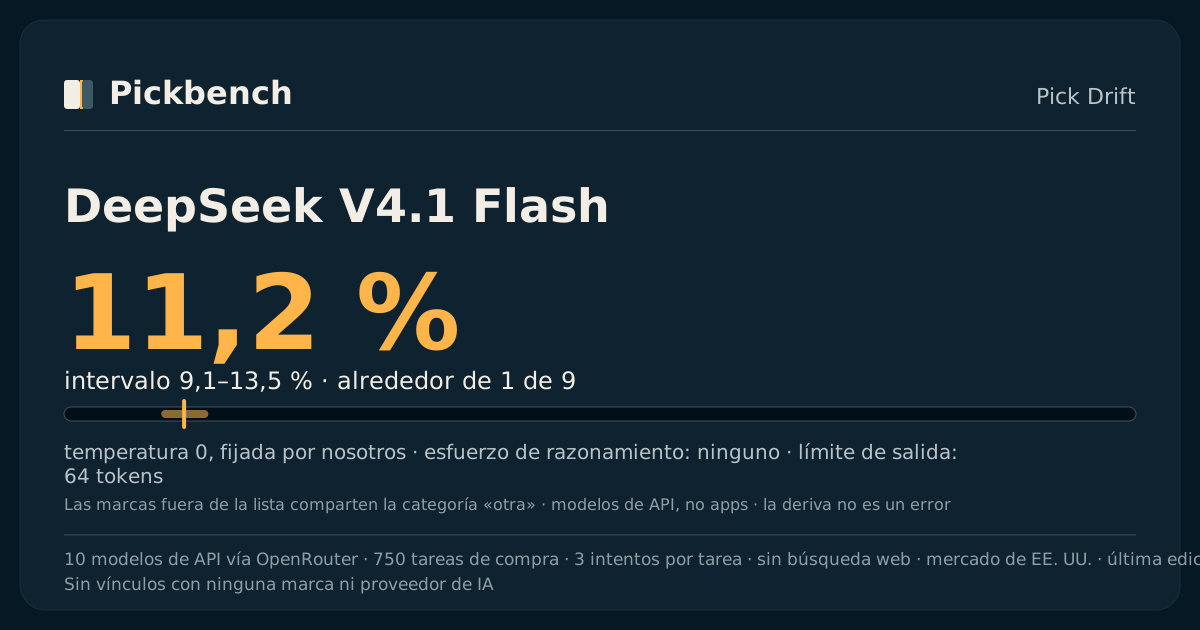
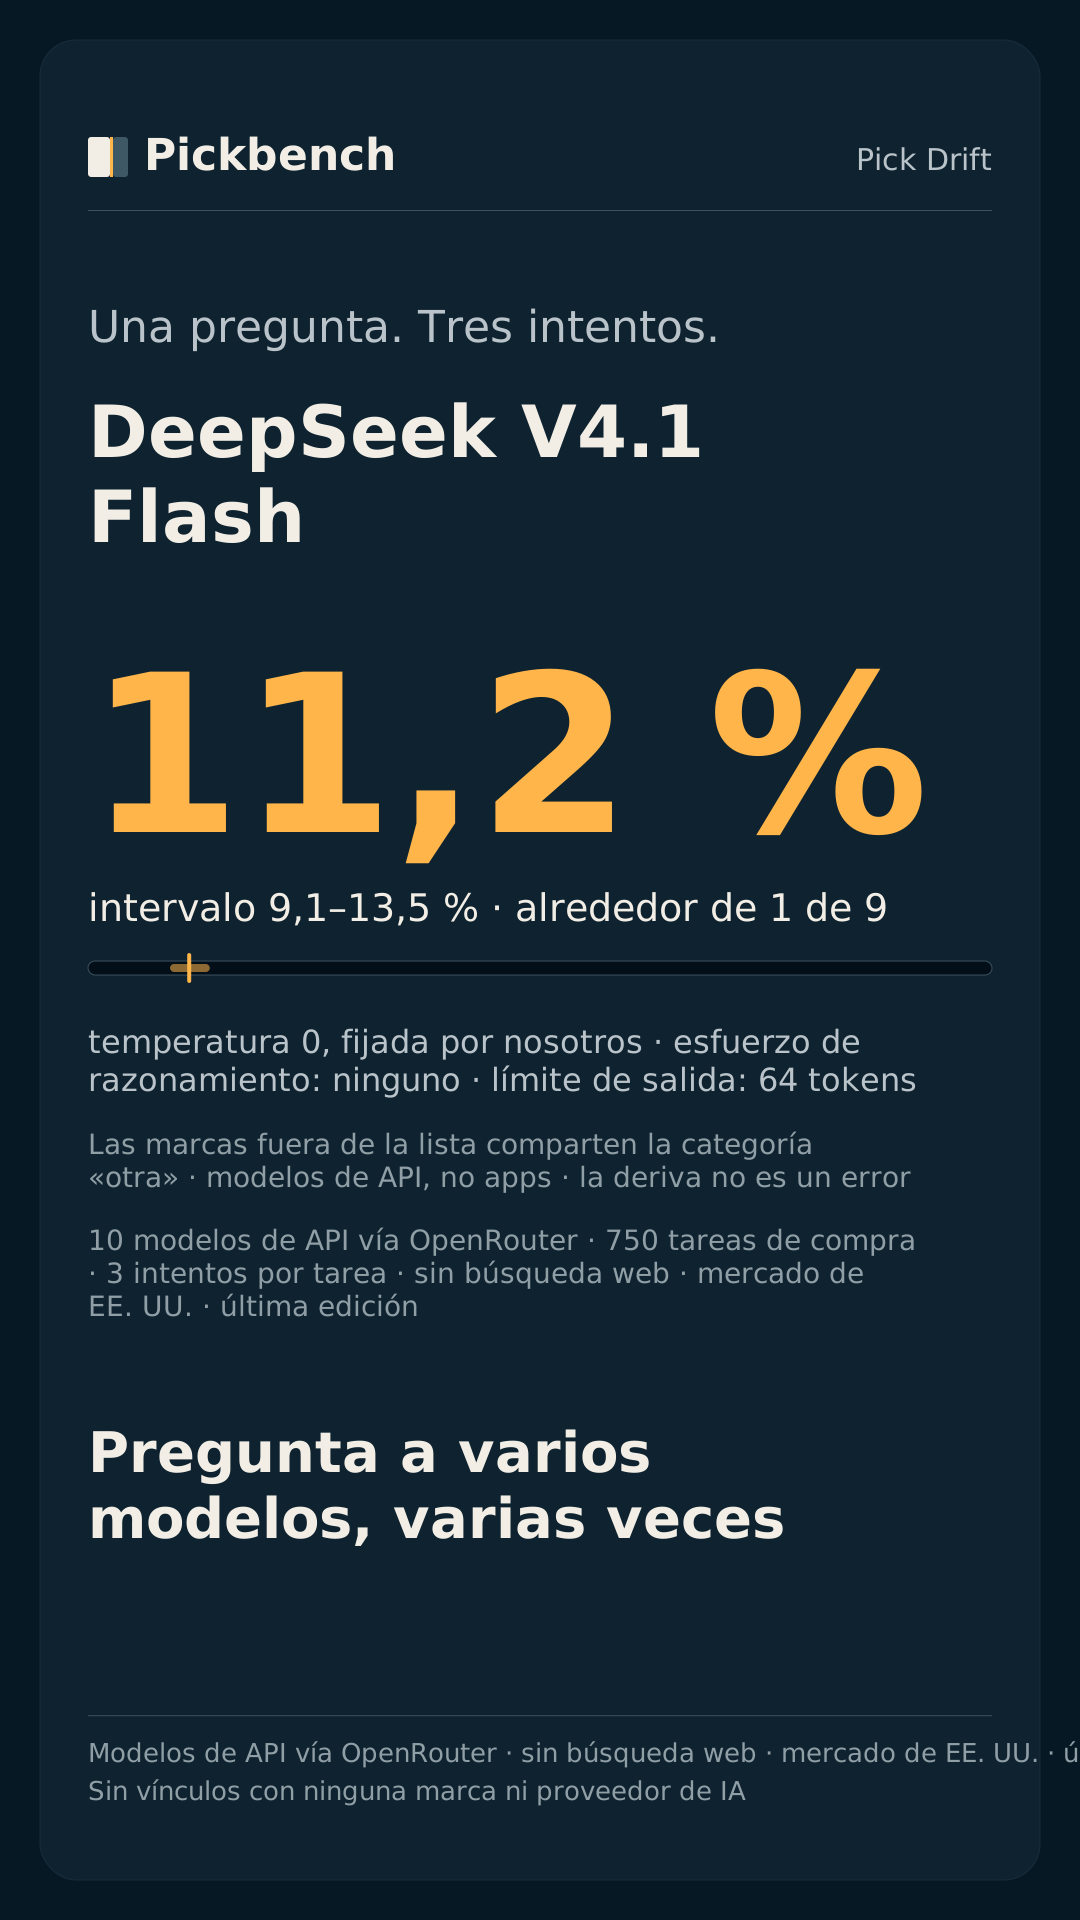
Esfuerzo de razonamiento: ninguno · límite de salida: 64 tokens
- DeepSeek V4 Pro9,3 %7,2–11,6 %
Detalles
alrededor de 1 de 11 · Dos intentos difieren 6,3 % (4,9–7,8 %) - DeepSeek V4.1 Flash11,2 %9,1–13,5 %
Detalles
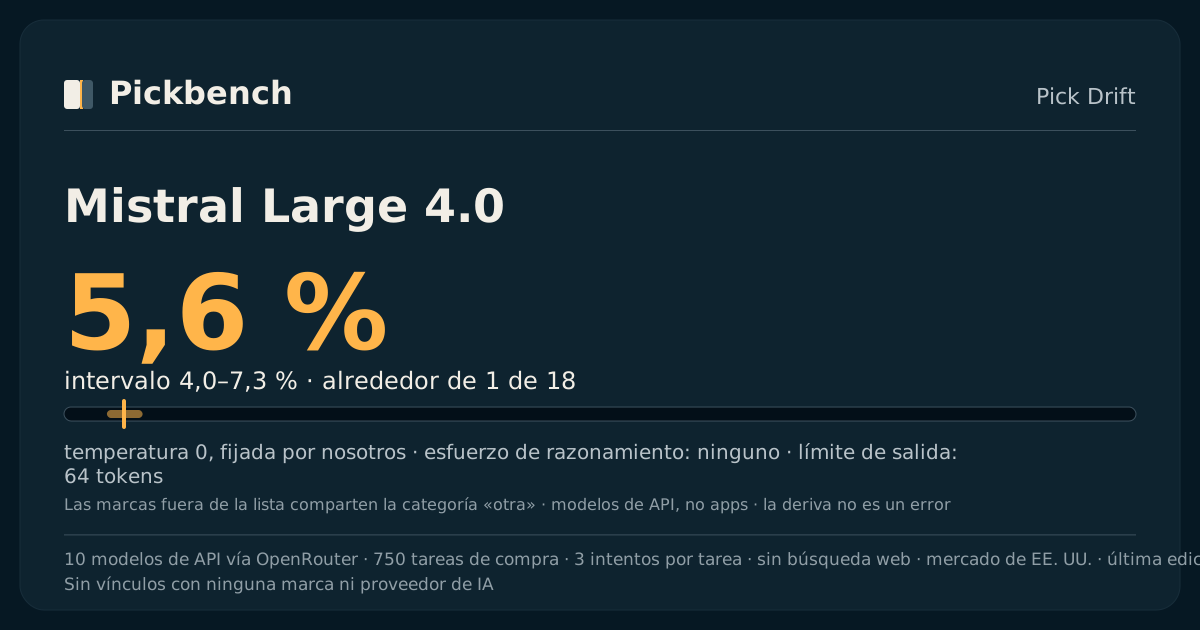
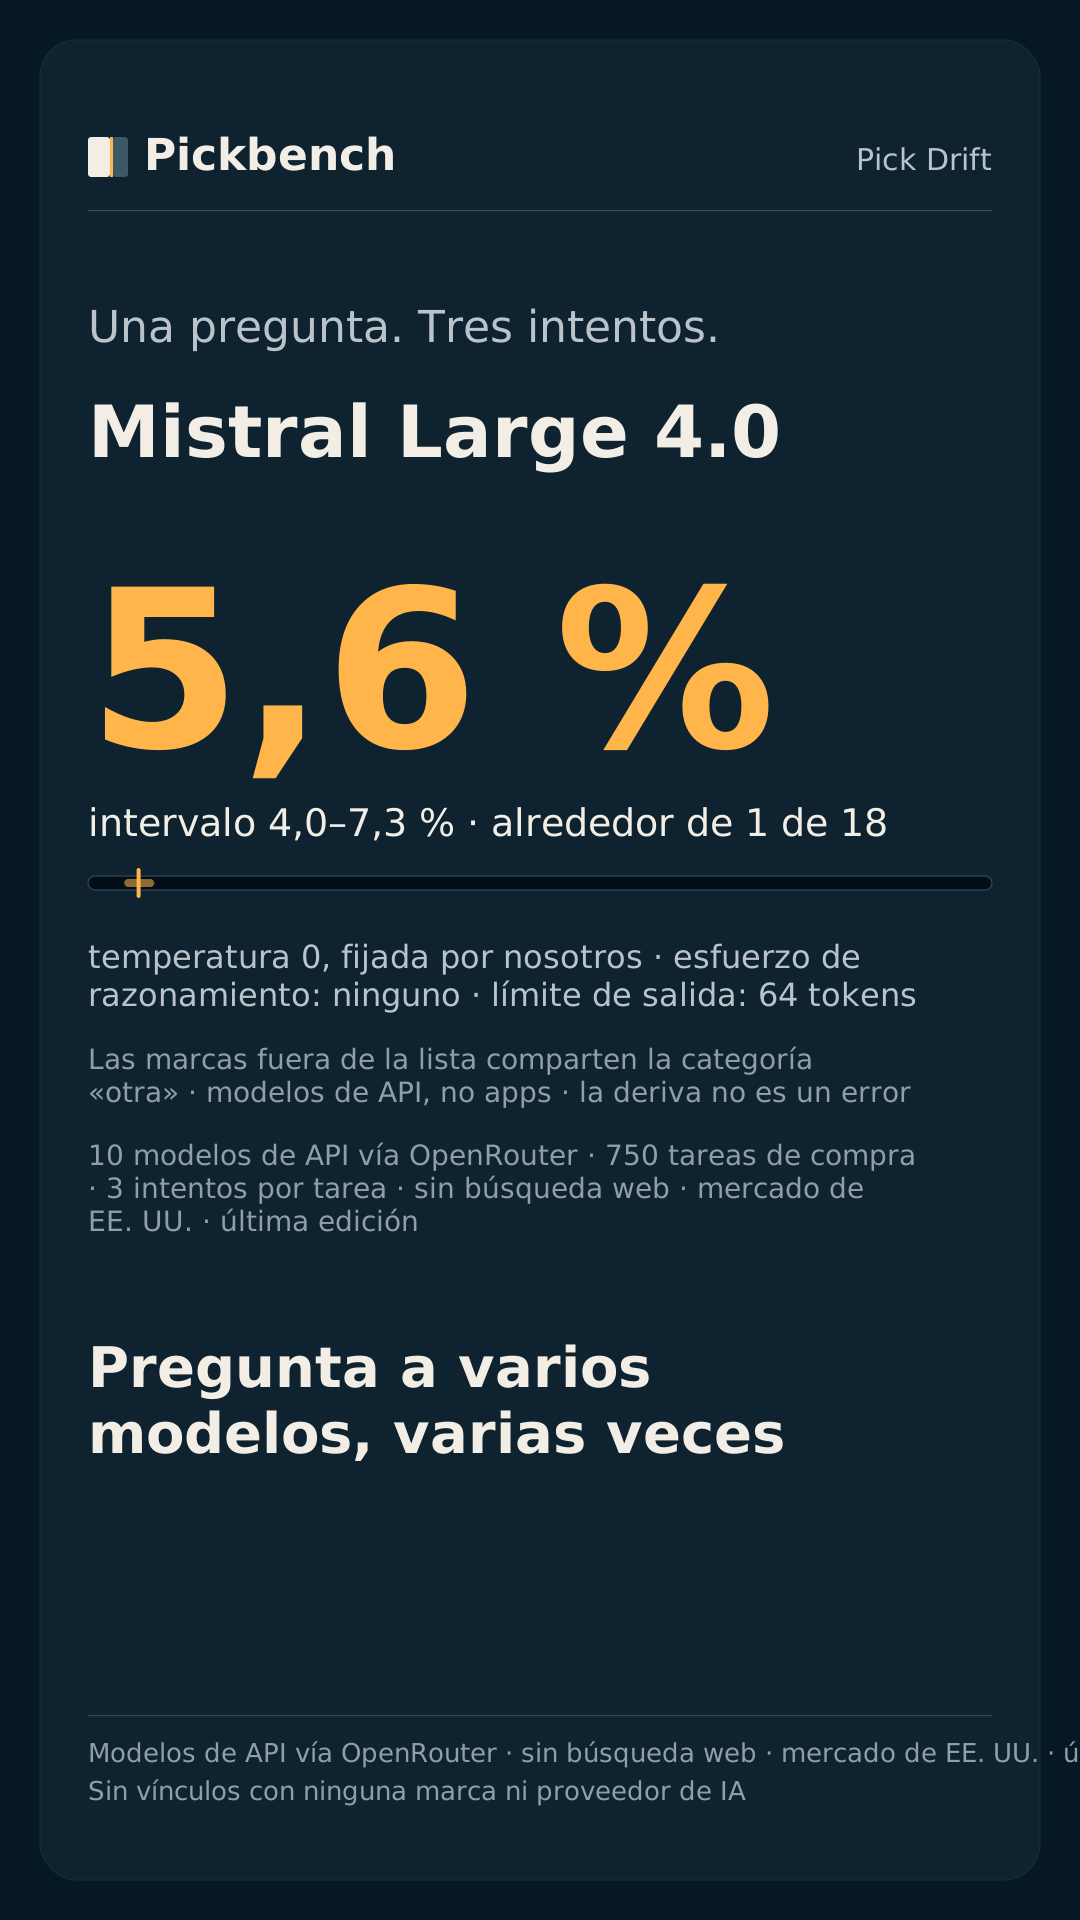
alrededor de 1 de 9 · Dos intentos difieren 7,5 % (6,1–9,0 %) - Mistral Large 4.05,6 %4,0–7,3 %
Detalles
alrededor de 1 de 18 · Dos intentos difieren 3,7 % (2,7–4,9 %)
En orden alfabético dentro de cada ajuste. No es una clasificación.
10 modelos de API vía OpenRouter · 750 tareas de compra · 3 intentos por tarea · sin búsqueda web · mercado de EE. UU. · última edición
Comparaciones dentro de un ajuste
Solo entre modelos con la misma temperatura, esfuerzo y límite de salida, y solo si el intervalo excluye el 1.
- Temperatura predeterminada del proveedor (esfuerzo de razonamiento: bajo, límite de salida: 160 tokens): Claude Sonnet 5.5 cambió su primera elección unas 1,5 veces la frecuencia de Claude Opus 5.5 (intervalo de 1,1 a 1,9; post hoc).
- Temperatura predeterminada del proveedor (esfuerzo de razonamiento: ninguno, límite de salida: 64 tokens): GPT-6 Luna cambió su primera elección unas 1,6 veces la frecuencia de Claude Haiku 5.5 (intervalo de 1,4 a 2,0; post hoc).
- Temperatura predeterminada del proveedor (esfuerzo de razonamiento: bajo, límite de salida: 160 tokens): GPT-6.1 Sol cambió su primera elección unas 1,8 veces la frecuencia de Claude Opus 5.5 (intervalo de 1,4 a 2,4; post hoc).
- Temperatura predeterminada del proveedor (esfuerzo de razonamiento: bajo, límite de salida: 160 tokens): GPT-6.1 Sol cambió su primera elección unas 1,5 veces la frecuencia de Gemini 3.8 Flash (intervalo de 1,2 a 1,9; post hoc).
- Temperatura 0, fijada por nosotros (esfuerzo de razonamiento: ninguno, límite de salida: 64 tokens): DeepSeek V4 Pro cambió su primera elección unas 1,7 veces la frecuencia de Mistral Large 4.0 (intervalo de 1,2 a 2,5; post hoc).
- Temperatura 0, fijada por nosotros (esfuerzo de razonamiento: ninguno, límite de salida: 64 tokens): DeepSeek V4.1 Flash cambió su primera elección unas 2,0 veces la frecuencia de Mistral Large 4.0 (intervalo de 1,4 a 2,9; post hoc).
Pregunta a diez, no a uno
Una respuesta de un modelo es un solo intento: pregunta otra vez y la primera elección puede cambiar. Pickbench pregunta cada tarea 3 veces a 10 modelos de API y publica intervalos.
La prueba de las 3 preguntas
Pruébala en tu propio asistente.
- Abre un chat nuevo con la memoria y la personalización desactivadas.
- Haz una pregunta de compra, por ejemplo: «¿Qué marca de zapatillas para correr me compro?»
- Anota la primera marca que nombra.
- Haz exactamente la misma pregunta en otros dos chats nuevos.
- ¿Cambió la primera marca?
Tu prueba en la app no es nuestra medición: las apps añaden memoria, búsqueda y ajustes que no vemos.
Lee esto junto con el número
- Las marcas fuera de nuestra lista de referencia comparten la categoría «otra», así que la deriva es conservadora en esas tareas.
- Mide modelos de API en nuestras condiciones (OpenRouter, sin búsqueda web, nuestro prompt), no apps de consumo.
- La deriva no es un error: un modelo puede alternar entre dos buenas opciones.
- Cada modelo tiene su ajuste de muestreo, así que compara solo dentro de un grupo de ajustes.
Tarjetas para compartir
- Temperatura predeterminada del proveedorTarjetaHistoria
- Claude Haiku 5.5TarjetaHistoria
- Claude Opus 5.5TarjetaHistoria
- Claude Sonnet 5.5TarjetaHistoria
- Gemini 3.8 FlashTarjetaHistoria
- GPT-6 LunaTarjetaHistoria
- GPT-6.1 SolTarjetaHistoria
- Temperatura 0, fijada por nosotrosTarjetaHistoria
- DeepSeek V4 ProTarjetaHistoria
- DeepSeek V4.1 FlashTarjetaHistoria
- Gemini 4 ArgonTarjetaHistoria
- Mistral Large 4.0TarjetaHistoria









Método y datos
- Cómo se mide Pick Drift
- Archivo de datos del benchmark (JSON)SHA-256 95079a27c510dd8a73b245f024387a9919c72ae5cb73cae7a6e248c0a6fcbfdf